




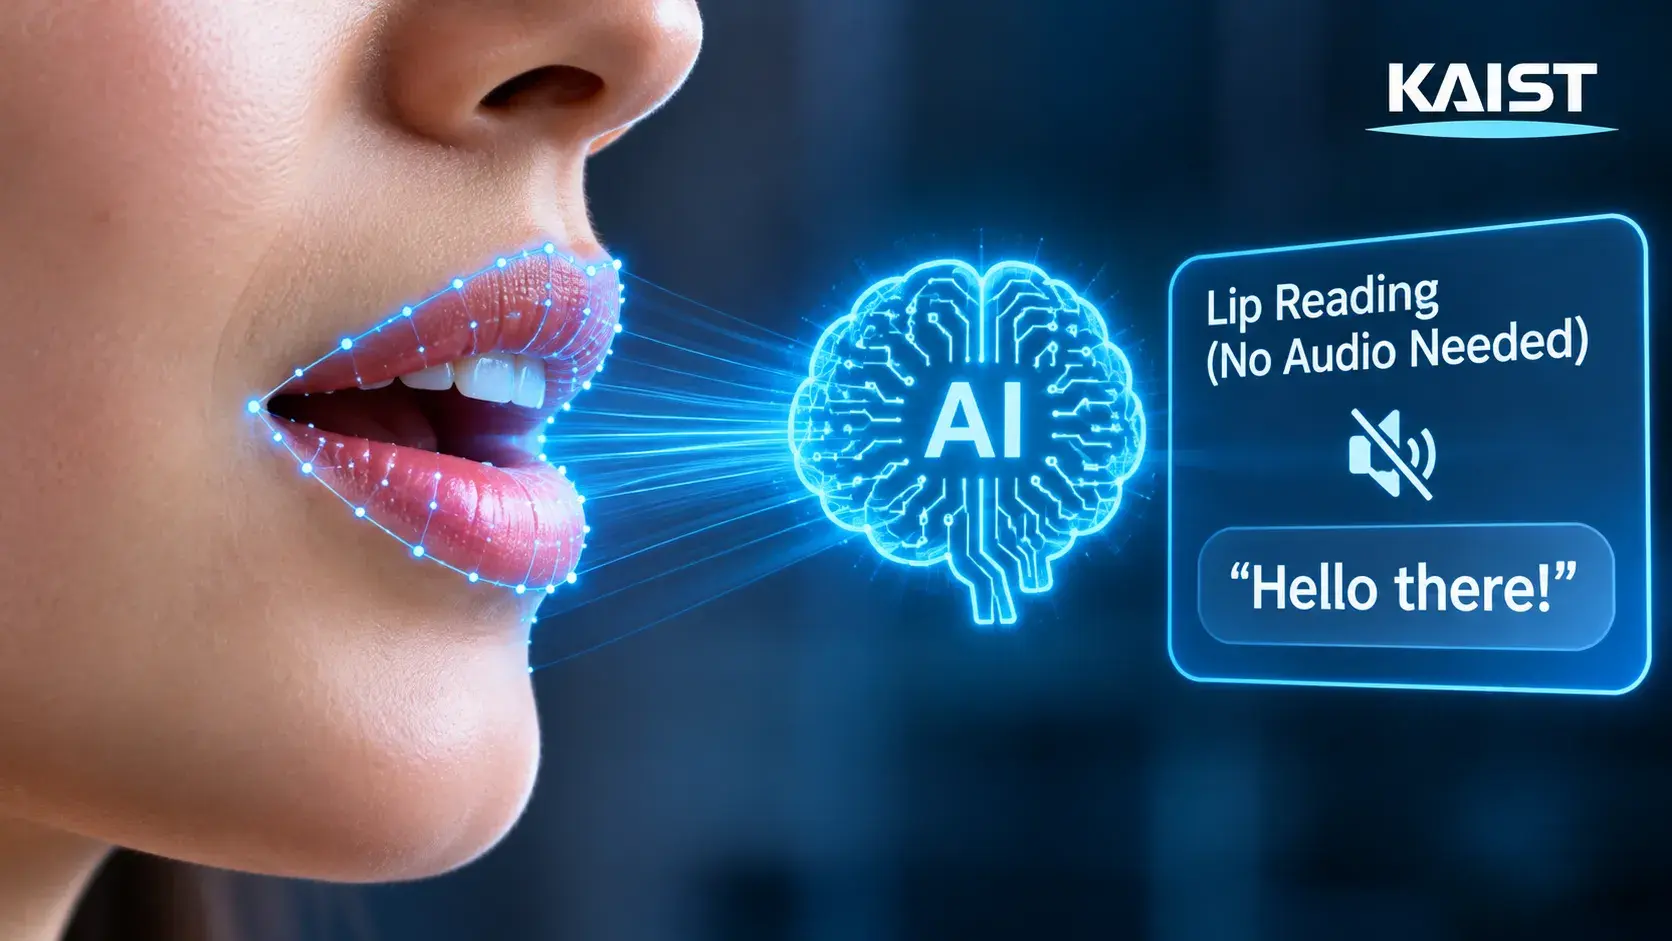
پژوهشگران کره جنوبی سامانه هوش مصنوعی جدیدی ساختهاند که بدون صدا، حرکت لب افراد را تحلیل و گفتار آنها را به متن تبدیل میکند. این فناوری در یک آزمون استاندارد به نرخ خطای کلمه ۱۹.۴ درصد رسیده و میتواند در محیطهای پر سروصدا و ابزارهای کمکارتباطی کاربرد داشته باشد.
به گزارش Digital Trends، پژوهشگران موسسه پیشرفته علوم و فناوری کره (KAIST) سامانه هوش مصنوعی جدیدی توسعه دادهاند که میتواند بدون دریافت هیچگونه صدایی، حرکت لب افراد را تحلیل کند و صحبتهای آنها را به متن تبدیل کند. این فناوری که DLLM-VSR نام دارد، از روشی متفاوت برای تشخیص کلمات استفاده میکند و در آزمایشهای انجامشده توانسته به دقت قابلتوجهی در مقایسه با روشهای مشابه برسد.
اهمیت این دستاورد فقط به تشخیص گفتار در محیطهای شلوغ محدود نمیشود. چنین فناوری میتواند در ابزارهای ارتباطی افراد ناشنوا و کمشنوا نیز کاربرد داشته باشد؛ هرچند برای استفاده روزمره هنوز به بهینهسازی بیشتری نیاز دارد.
هوش مصنوعی چگونه بدون صدا لبخوانی میکند؟
لبخوانی حتی برای انسانها نیز کار سادهای نیست. برخی حروف مانند «پ»، «ب» و «م» هنگام تلفظ، حرکتهای تقریبا مشابهی در لب ایجاد میکنند. به همین دلیل، تشخیص دقیق کلمات تنها با مشاهده دهان دشوار است و معمولا به شناخت موضوع صحبت و جملههای قبل و بعد نیاز دارد.
روشهای قدیمیتر هوش مصنوعی اغلب کلمات را بهترتیب و از ابتدای جمله تشخیص میدهند. این شیوه یک مشکل اساسی دارد؛ اگر مدل در تشخیص کلمه نخست اشتباه کند، احتمال دارد همان خطا روی پیشبینی کلمات بعدی نیز تاثیر بگذارد.
پژوهشگران کرهای برای حل این مشکل از مدل زبانی بزرگ مبتنی بر انتشار (Diffusion Large Language Model) استفاده کردهاند. این مدل بهجای خواندن جمله از ابتدا تا انتها، ابتدا سراغ بخشهایی میرود که درباره تشخیص آنها اطمینان بیشتری دارد. سپس با استفاده از کلمات شناساییشده و بررسی همزمان اطلاعات قبل و بعد، قسمتهای مبهم جمله را تکمیل میکند.
ثبت نرخ خطای ۱۹.۴ درصدی در آزمایشها
تیم تحقیقاتی برای ارزیابی این فناوری از مجموعه داده LRS3 استفاده کرده است که شامل ۴۳۳ ساعت ویدیوی دارای متن مرجع برای آموزش و آزمایش سامانههای لبخوانی میشود.
سامانه DLLM-VSR در این آزمایش به نرخ خطای کلمه (WER) برابر با ۱۹.۴ درصد رسید. این عدد پایینترین نرخ خطای گزارششده در میان روشهایی بود که فقط از دادههای همین مجموعه برای آموزش استفاده کرده بودند.
البته نرخ خطای ۱۹.۴ درصد به این معنا نیست که هوش مصنوعی در ۸۰.۶ درصد مکالمات، تمام جملات را بدون اشتباه تشخیص داده است. این معیار تعداد کلمات اشتباه، حذفشده یا اضافهشده را در مقایسه با متن اصلی اندازهگیری میکند و هرچه کمتر باشد، عملکرد مدل بهتر است.
کاربردهای احتمالی فناوری جدید KAIST
یکی از مهمترین کاربردهای این فناوری، کمک به ارتباط افراد ناشنوا و کمشنوا است. در صورت توسعه، ابزارهای مجهز به DLLM-VSR میتوانند حرکت لب افراد را دریافت کنند و محتوای گفتوگو را به شکل متن نمایش دهند.
محیطهای صنعتی نیز از دیگر زمینههای احتمالی استفاده از این فناوری هستند. برای مثال، در کارخانههایی که صدای دستگاهها و ماشینآلات امکان شنیدن مکالمات را دشوار میکند، چنین سامانهای میتواند به تشخیص صحبت کارکنان کمک کند.
بااینحال، عملکرد مدل در شرایط مختلف یکسان نیست. در آزمایش روی مجموعه داده دیگری به نام WildVSR، نرخ خطای آن به ۳۹.۹ درصد رسید. این اختلاف نشان میدهد شرایط تصویربرداری، محیط و تفاوت میان دادههای آموزشی و واقعی همچنان بر دقت لبخوانی تاثیر دارند.
فناوری DLLM-VSR نشان میدهد تغییر روش پردازش اطلاعات میتواند حتی بدون افزایش حجم دادههای آموزشی، دقت سامانههای هوش مصنوعی را بهبود دهد. بااینحال، اختلاف عملکرد در مجموعه دادههای مختلف نشان میدهد این فناوری هنوز برای استفاده گسترده آماده نیست. اگر پژوهشگران بتوانند دقت آن را در شرایط واقعی افزایش دهند و هزینه پردازش را کاهش دهند، لبخوانی هوشمند میتواند به یکی از ابزارهای مهم ارتباطی در آینده تبدیل شود.