



شرکت Thinking Machines مدل هوش مصنوعی متنباز Inkling 2 Mini را با ۲۶.۴ میلیارد پارامتر معرفی کرده است که میتواند بهصورت محلی و بدون اتصال اینترنت روی مکهای مجهز به حداقل ۳۲ گیگابایت حافظه یکپارچه اجرا شود. این مدل با معماری ترنسفورمر حلقهای، در برنامهنویسی و استدلال عملکرد قابل توجهی دارد و به حافظهای حدود ۲۰ گیگابایت نیازمند است.
مدل Inkling 2 Mini از معماری ترنسفورمر ۲۴ لایهای با ساختار Mixture of Experts (MoE) استفاده میکند. این مدل در مجموع ۲۶.۴ میلیارد پارامتر دارد که تنها ۳.۴ میلیارد پارامتر آن بهصورت فعال در پردازش معمول هر توکن مشارکت میکنند. بااینحال، ویژگی اصلی معماری آن به نحوه اجرای لایههای داخلی مربوط میشود.
در این طراحی، ۱۲ لایه میانی سه بار اجرا میشوند، درحالیکه شش لایه ابتدایی و شش لایه پایانی فقط یک بار فعالیت میکنند. درنتیجه، هر توکن بهجای عبور از ۲۴ مرحله لایهای، مجموعا ۴۸ بار پردازش لایهای را تجربه میکند. این روش باعث میشود مدل محاسبات بیشتری برای استدلال انجام دهد، بدون اینکه به همان نسبت به پارامترهای ذخیرهشده بیشتری نیاز داشته باشد.
به گفته سازندگان، این معماری به مدل اجازه میدهد پیش از تولید پاسخ، پردازش داخلی بیشتری انجام دهد. تعداد پارامترهای فعال موثر آن نیز با درنظرگرفتن تکرار لایهها به ۵.۴ میلیارد میرسد.
عملکرد در آزمونهای برنامهنویسی و هوش مصنوعی
نتایج آزمایشهای منتشرشده از سوی Thinking Machines نشان میدهد که Inkling 2 Mini در برخی آزمونهای برنامهنویسی عملکرد رقابتی دارد. این مدل در آزمون DeepSWE v1.1 امتیاز ۴۸.۲ درصد و در SWE-bench Pro v2 Hard امتیاز ۷۷.۹ درصد را کسب کرده است.
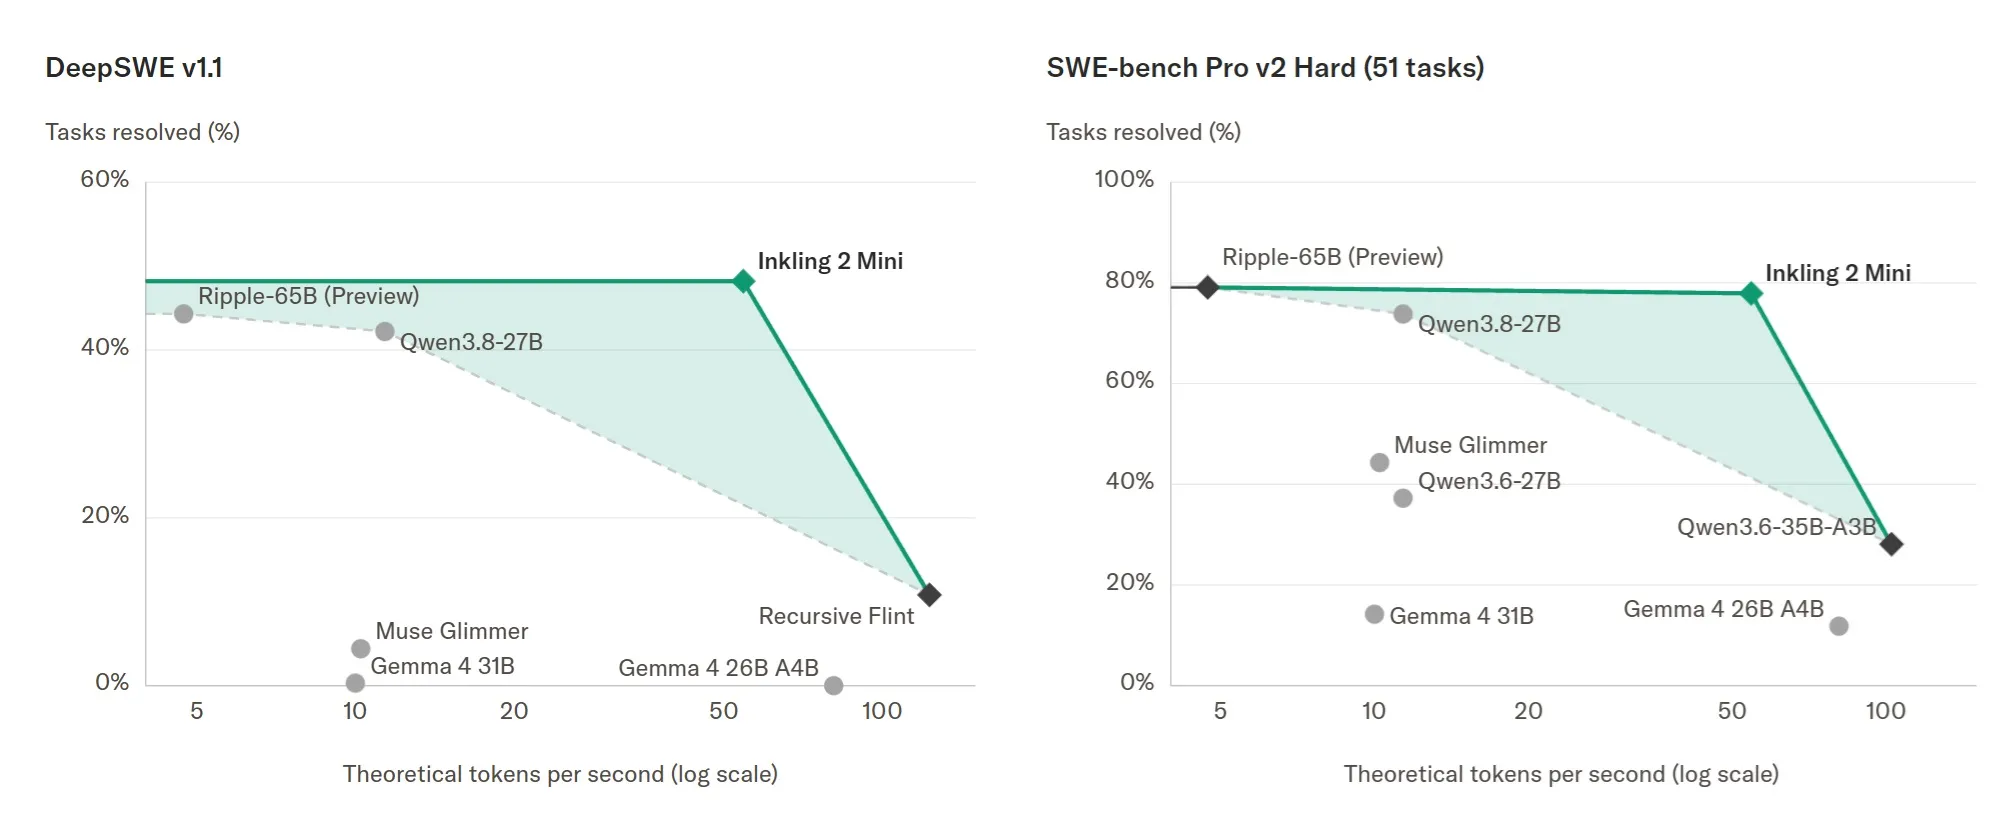
در آزمون Vals Index v2.2 نیز امتیاز ۴۶.۵ درصد برای آن ثبت شده و شاخص هوش Artificial Analysis آن به ۲۰.۱ رسیده است. البته این امتیاز در شاخص اخیر با مدل Qwen3.8-27B برابر است و نباید تمام نتایج را نشانه برتری مطلق Inkling 2 Mini دانست.
یکی دیگر از ویژگیهای مهم این مدل، پشتیبانی از ورودی متنی و تصویری است. پنجره متنی آن نیز حداکثر یک میلیون توکن ظرفیت دارد؛ قابلیتی که برای تحلیل اسناد طولانی و پروژههای برنامهنویسی پیچیده اهمیت دارد.
اجرای آفلاین روی مکبوک با ۳۲ گیگابایت حافظه
مهمترین ویژگی Inkling 2 Mini امکان اجرای محلی آن روی سختافزارهای مصرفی است. حجم حافظه موردنیاز مدل حدود ۲۰ گیگابایت اعلام شده و کاربران میتوانند آن را روی دستگاههای مجهز به پردازنده اپل سیلیکون و حداقل ۳۲ گیگابایت حافظه یکپارچه اجرا کنند.
این مدل ازطریق ابزار Ollama روی مک پشتیبانی میشود. همچنین رایانه هوش مصنوعی انویدیا DGX Spark از گزینههای رسمی اجرای آن است. برای سایر پیکربندیهای مبتنی بر کارت گرافیک نیز حداقل ۳۲ گیگابایت حافظه گرافیکی توصیه شده است.
Thinking Machines برای نمایش توانایی مدل، آن را روی مکبوک پرو مجهز به تراشه M5 پرو و ۴۸ گیگابایت حافظه یکپارچه آزمایش کرده است. در این نمایش، مدل بدون اتصال اینترنت و در حالت پرواز، طی چند دقیقه یک شبیهساز پرواز قابل بازی تولید کرد. همچنین در پروژه Thinkyville، مدیریت رفتار ۲۰ شخصیت مستقل در یک شهر پیکسلی به همین مدل سپرده شد.
مدل Inkling 2 Mini نشان میدهد که برای دستیابی به عملکرد مناسب در وظایف پیچیده هوش مصنوعی، افزایش تعداد پارامترها تنها راهکار موجود نیست. معماری حلقهای این مدل با استفاده مجدد از لایههای میانی، امکان پردازش بیشتر را بدون افزایش متناسب حجم وزنها فراهم کرده است. اجرای آفلاین روی مکهای مجهز به ۳۲ گیگابایت حافظه نیز میتواند استفاده از ابزارهای هوش مصنوعی محلی را برای توسعهدهندگان سادهتر کند. بااینحال، محدودیت در برخی مکالمات پیچیده و پرسشهای مربوط به شفافیت استدلال نشان میدهد که این مدل هنوز برای همه کاربردها جایگزین مناسبی برای مدلهای بزرگتر نیست.